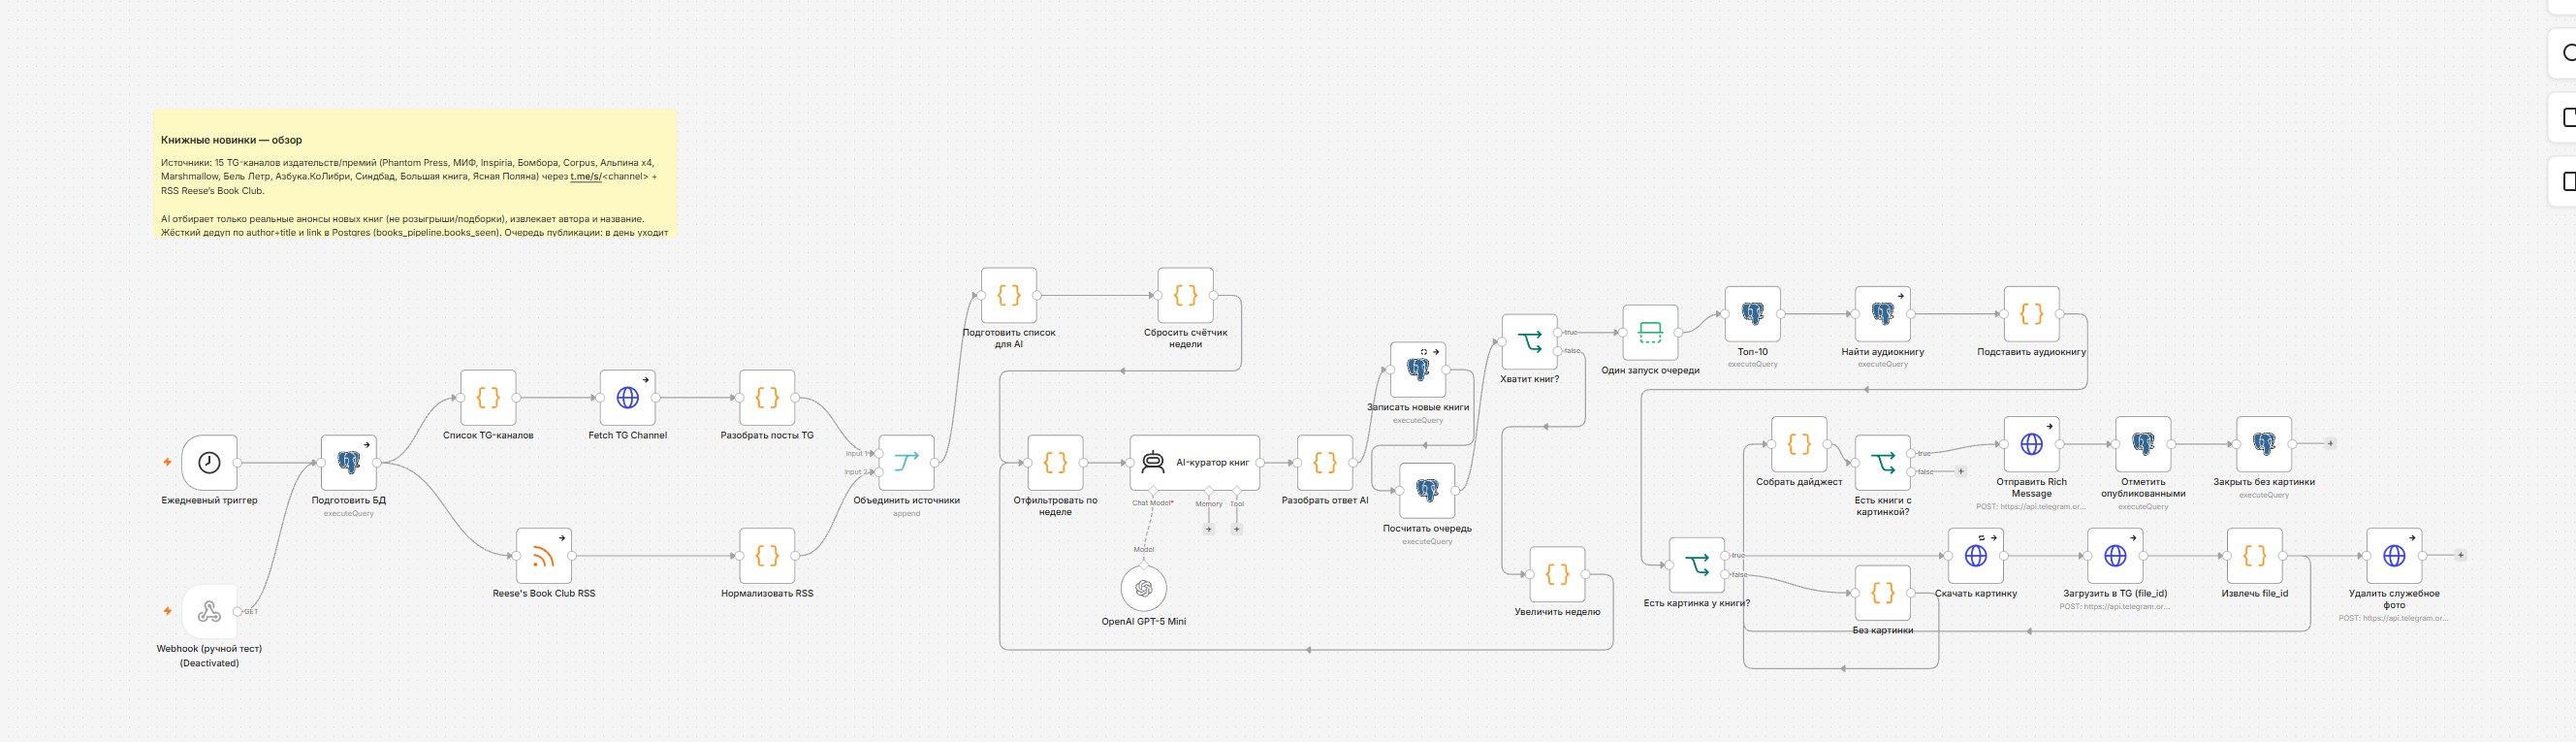
У меня есть книжный TG-канал — дайджест, куда три раза в день публикуются посты — с обложкой, автором, коротким описанием и ссылкой на источник. Я выбрал именно формат дайджеста именно потому, что в этом процессе не участвую вообще. Если делать полноценную контент-фабрику, человека надо включать в цепочку автоматизации для утверждения постов, я хотел от этого отстраниться, у меня есть 4 канала, которые я согласовываю ручками.
Ниже — как это устроено на уровне узлов n8n, для тех, кто сам собирает автоматизацию и упёрся в похожие задачи: агрегация из источников, дедуп, ИИ-фильтрация, публикация в Telegram сложнее, чем один sendMessage. По уровню сложности это примерно вторая-третья ступень из лестницы внедрения ИИ — узкоспециализированный ассистент, а не общий чат-бот на все случаи жизни.
Источники: зачем Telegram-каналы читать без бота
Дайджест собирается примерно из двадцати каналов издательств и литературных премий плюс один RSS-фид зарубежного книжного клуба. Для Telegram-каналов бот никуда не добавлен и никуда не подписан — вместо Bot API пайплайн просто открывает публичную веб-версию канала (t.me/s/<имя_канала>) как обычную HTML-страницу через HTTP Request и разбирает вёрстку регулярками в Code-ноде: ищет блоки постов, вытаскивает текст, дату, ссылку на пост и превью-картинку из фонового стиля div'а.
Это не самый элегантный способ (вёрстка t.me может измениться), но у него важное преимущество для новичка: не нужно быть админом канала и не нужен токен, чтобы читать чужой публичный канал. Для источника, который отдаёт нормальный RSS, всё проще — стандартная RSS-нода плюс нормализация полей под общий формат (заголовок, описание, ссылка, дата, картинка), чтобы дальше по пайплайну Telegram-посты и RSS-записи выглядели одинаково.
Дедуп в три слоя, а не в один
Первая ошибка, которую легко допустить в таком пайплайне, — понадеяться на один уровень дедупликации. Здесь их три, и каждый ловит свой класс дублей.
Слой 1, на лету. Перед тем как отдавать список ИИ, код собирает Set уже встреченных ссылок, отбрасывает дубли и всё, что старше 28 дней, сортирует по дате и обрезает до 300 записей. Это не столько дедуп, сколько экономия — не скармливать модели вперемешку месяц контента на каждый прогон.
Слой 2, в базе. Таблица в Postgres держит уникальный индекс по паре автор+название, приведенных к нижнему регистру (чтобы «Пелевин» и «пелевин» считались одной и той же книгой), и отдельный уникальный индекс по ссылке. Вставка новых книг идёт через INSERT ... ON CONFLICT DO NOTHING RETURNING — если ИИ на двух разных прогонах извлёк одну и ту же книгу из разных постов, в базу попадает только первая запись. Это по-настоящему надёжный слой, потому что дедуп по ссылке в коде не спасает, если книгу анонсировали второй раз с новым постом и новым URL, или даже в другом источнике.
Слой 3, по времени. Пайплайн разбирает посты не всей кучей, а окнами по неделе, начиная с самой свежей. Если после ИИ-отбора в очереди остаётся меньше пяти книг, скрипт сдвигает окно на неделю назад и повторяет отбор — но не бесконечно, а максимум три недели вглубь. Смещение окна хранится в staticData воркфлоу между прогонами, то есть переживает рестарт n8n. Это защита от тишины: если издательства неделю ничего не публиковали, дайджест не встанет колом.
ИИ как курьер, а не как автор
Модели (GPT-4o-mini через LangChain-агента) я не доверяю ссылку, источник или дату — эти поля уже есть в данных, и модель их не видит вообще. Ей показывают только пронумерованный список постов и просят вернуть строгий JSON вида {"books": [{"index": 0, "author": "...", "title": "...", "blurb": "..."}]}. index — это номер поста в исходном списке, а не что-то, что модель придумывает. Дальше код по этому index достаёт настоящую ссылку, источник и картинку из оригинальных данных и склеивает их с тем, что вернула модель.
Смысл в том, чтобы просить у ИИ решать только то, что действительно требует суждения: это вообще анонс новой книги или что-то другое — розыгрыш, реклама, подборка без конкретного названия; кто автор; как называется книга; и написать про неё пять предложений по делу. А всё, что и так известно точно — ссылку, источник, дату, — брать не у модели, а напрямую из данных. Модель, которой не дали галлюцинировать ссылку, не может её и переврать.
Второй момент — в системный промпт вписаны конкретные замеченные случаи мусора, а не общие инструкции. Один из источников — общая рекомендательная лента, а не издательский канал, и туда время от времени просачивается реклама вакансий под видом обычного поста. Вместо абстрактного «отсеивай спам» в промпте прямо написано: из этого источника вакансии и подработка — не книга, игнорировать полностью. Абстрактная инструкция такое пропускает, потому что формально пост выглядит как обычный текст; конкретный пример, увиденный на реальных данных, ловит его стабильно.
Публикация — по очереди, а не по факту находки
Отбор книг и их публикация — разные по темпу процессы, и смешивать их в один шаг было бы ошибкой. Найденные и прошедшие ИИ книги просто копятся в базе со статусом «не опубликовано». Отдельный шаг на каждый прогон берёт из очереди не больше десяти самых старых непубликованных записей (FIFO) — независимо от того, нашлось за день три новых анонса или тридцать. Расписание публикаций (три раза в день) остаётся стабильным вне зависимости от того, сколько постов было отобрано на входе.
Ещё один фильтр в этой точке — публикуются только книги с картинкой. Если у анонса нет изображения, запись отдельным шагом закрывается (тоже помечается как опубликованная) и просто не попадает в канал. Это сознательное решение, а не забытая мелочь: пост без обложки в книжном дайджесте выглядит бедно, и проще пропустить пару анонсов без картинки, чем публиковать голый текст.
Rich text — ради чего всё затевалось
У обычного текстового сообщения в Telegram есть только parse_mode HTML/Markdown — одна строка с разметкой, и медиа отдельно. Но недавно у Bot API появился отдельный, официальный метод именно для составных постов — sendRichMessage. Он принимает объект с полем blocks: сообщение собирается не как единый текст, а как последовательность типизированных кусков — заголовок, абзац, фото, разделитель и так далее. Метод сам раскладывает эти блоки в аккуратно оформленный пост — пайплайну в n8n остаётся только правильно собрать JSON, а не мастерить вёрстку руками.
У sendRichMessage помимо заголовков, абзацев, фото и разделителей есть блоки посерьёзнее: списки, таблицы, кнопки, цитаты, даже код и математические формулы — то есть можно собрать не просто дайджест, а почти полноценную мини-страницу внутри одного сообщения. На каждую книгу пайплайн использует только нужный минимум: заголовок с названием, заголовок поменьше с автором, фото (если есть), абзац с описанием, отдельный абзац-ссылку на источник — и разделитель между книгами. Для новичка вывод простой: если в Telegram хочется опубликовать не просто текст, а что-то структурированное — не нужно изобретать способ впихнуть вёрстку в одну строку через HTML-сущности, достаточно открыть документацию sendRichMessage и собрать нужный набор блоков в JSON.
Если же собирать такие посты вручную каждый раз не хочется даже через JSON — под эту же задачу у меня есть готовый инструмент: Rich Composer, блочный редактор постов для Telegram-канала с тем же набором элементов (заголовки, цитаты, таблицы, кнопки), но без единой строчки кода.
Обходной манёвр с картинкой
Отдельный трюк — как в rich-message попадает фотография, найденная на чужом сайте. Сам sendRichMessage ждёт в блоке с фото не URL картинки, а Telegram file_id — идентификатор, который выдаётся только после того, как файл уже загружен в Telegram через бота. Поэтому пайплайн сначала скачивает картинку по ссылке, отправляет её через sendPhoto в служебный чат, забирает из ответа file_id, а временное сообщение с фото сразу удаляет. Дальше в rich-message идёт уже не внешний URL, а этот file_id.
Не самое очевидное поведение, если не знать, что file_id — это токен, привязанный к конкретному боту и файлу внутри Telegram, а не постоянная публичная ссылка. Скачать картинку и перезалить её в Telegram под своим ботом — стандартный приём для любой задачи, где внешнее изображение нужно засунуть в Telegram-нативный компонент, который принимает только file_id, а не произвольный URL.
Инфраструктура — не то же самое, что данные
После первого же запуска пайплайна выяснилось: скрейпер Tavily просто не отвечает. А он был нужен для поиска на зарубежных ресурсах. Инстанс n8n стоял на российском сервере, и до Tavily оттуда было не достучаться. Чинить сеть смысла не было — я перенёс весь воркфлоу на инстанс, развёрнутый на зарубежном сервере, и Tavily сразу заработал. Postgres с историей всех найденных книг при этом остался общим: оба инстанса n8n подключаются к одной и той же базе, каждый по своим учётным данным.
Это стоит закладывать в архитектуру заранее: если пайплайн держит важные данные внутри workflow static data или, тем более, только в памяти прогона, переезд между серверами — тем более между разными странами размещения — означает потерю истории. Здесь переезд стоил только смены креденшелов Postgres в новом инстансе: сама база, а с ней весь прогресс по уже найденным и опубликованным книгам, осталась нетронутой.
Такие пайплайны собираю не только для себя
Похожие сборки делаю и клиентам под их задачи. Из недавнего — похожий пайплайн запущен для группы по продовольственному ретейлу: канал t.me/producttoday_digest собирает данные не с одного источника, а сразу с выбранных Telegram-каналов, RSS-лент и по широкому поиску в русскоязычном интернете по интересующей тематике, и превращает это в дайджест по той же логике, что описана выше. Ещё один пример того же класса задачи — «ИИ-куратор» вместо «ИИ-автор» — можно посмотреть в кейсе генератора бизнес-стратегий из обсуждений на Reddit, а другие автоматизации собраны в разделе кейсов.