В Telegram разошлась новость: ChatGPT, Claude, Gemini, Grok и Copilot ошибаются в 57% финансовых ответов, на сложных вопросах до 99%. Мы нашли первоисточник и выяснили, что исследование заказала компания, которая сама продаёт ИИ для финансовых консультантов. Поэтому одним отчётом не ограничились и нашли ещё четыре, независимых. Цифры у всех разные, а вывод один, и он важен для любого бизнеса, который собирается доверить ИИ ответы клиентам.
Исследование из новости: Saturn, 57%
Отчёт называется «Artificial Authority: стоит ли доверять ИИ финансовые советы?». 18 моделям задали 121 вопрос о деньгах: пенсии, налоги, долги, сбережения, ипотека. Каждый вопрос повторили пять раз, чтобы проверить, одинаково ли модель отвечает, отсюда «больше 10 тысяч ответов».
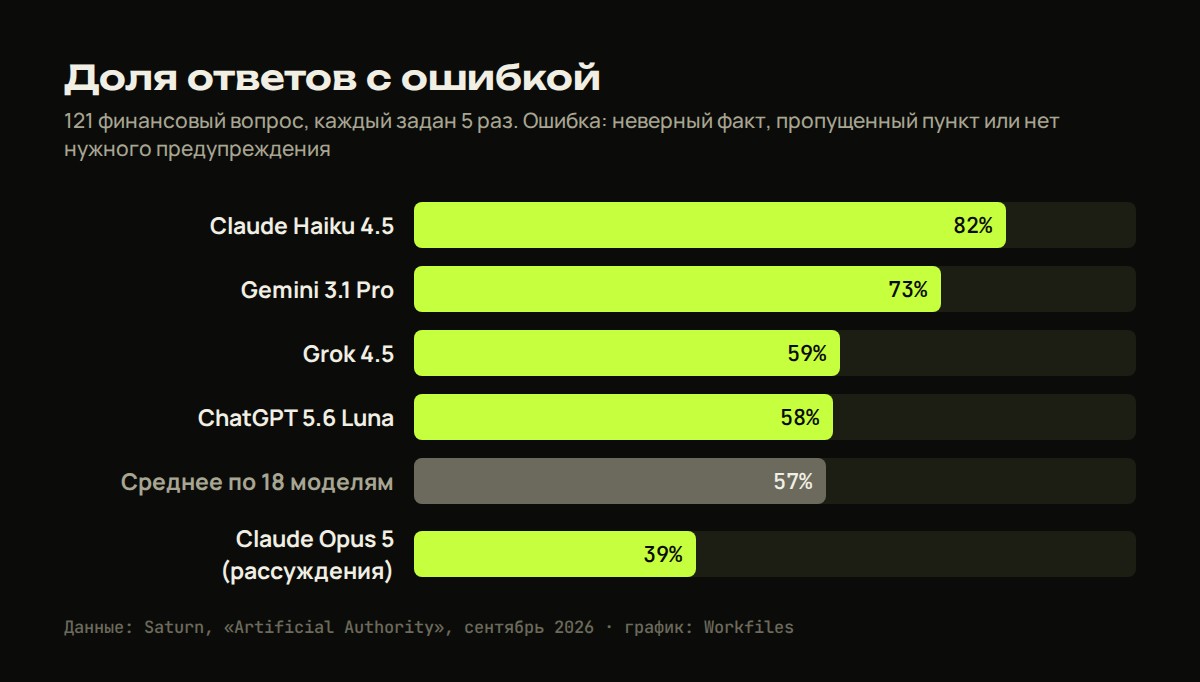
Ошибкой считался не только неверный факт. Ответ засчитывали как провал, если в нём была фактическая ошибка, если модель пропустила важный пункт или не дала предупреждение, которое должен дать консультант. Итог: 57% провалов в среднем, 88% на сложных вопросах, а у некоторых моделей до 99% на самых трудных.
Бесплатные версии ошибались чаще платных: 63% против 49%. Худший результат у Claude Haiku 4.5, 82% ошибок, дальше Gemini 3.1 Pro (73%), Grok 4.5 (59%), ChatGPT 5.6 Luna (58%). Лучший результат у Claude Opus 5 в режиме рассуждений, но и он ошибся в 39% ответов, почти в четырёх из десяти.
Примеры ошибок из отчёта:
- Ответ про налоги на пенсионные накопления мог обернуться для человека начислением от налоговой на £17 500.
- Людям в долгах модели советовали сначала гасить кредиты с самой высокой ставкой, а не аренду и муниципальный налог. В Британии это прямой путь к выселению и приставам.
- Одна модель придумала правило, будто выпускник может перестать платить студенческий кредит, если уедет за границу. На деле платёж в такой ситуации только вырастет.
- Gemini сказала заёмщику, что ипотечные каникулы не повлияют на кредитную историю. Это неправда.
Как новость изменилась в пересказе
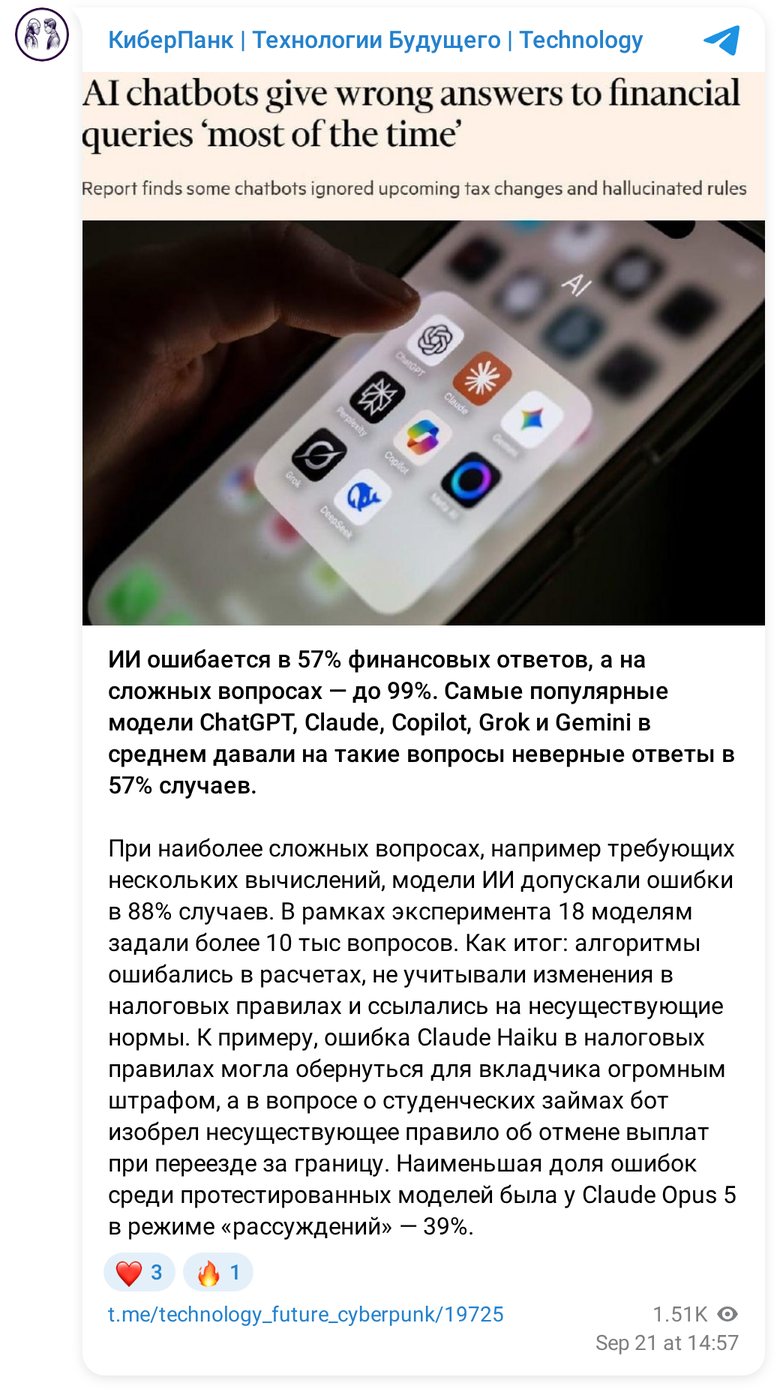
- В пересказе ошибку со штрафом приписали Claude Haiku. В отчёте и британской прессе она не привязана ни к одной модели: сказано «одна ошибка по пенсионным налогам». Haiku просто худшая модель по общему счёту.
- Пропало, что все вопросы про британские правила: британская налоговая, британские студенческие кредиты, британская ипотека. На российских вопросах цифры могли быть другими, но такой проверки никто не делал.
- Пропало, что «ошибка» включает пропущенное предупреждение. Модель могла назвать верную цифру, но не предупредить о риске, и это тоже провал.
- Пропал самый опасный пример, с долгами. А главное, пропало, кто всё это посчитал.
Кто посчитал и зачем
Исследование сделала и оплатила британская компания Saturn. Она сама придумала методику и сама ставила оценки, что честно отмечают британские издания. Saturn делает ИИ для финансовых консультантов: компания прошла Y Combinator и привлекла $15 млн инвестиций.
Вывод отчёта звучит не «ИИ опасен», а «универсальный чат-бот опасен, нужен ИИ с ограничениями, под контролем специалиста». Ровно это Saturn и продаёт. Цифры от этого не становятся неверными, но независимой повторной проверки нет. Поэтому мы поискали другие исследования: с другими заказчиками, в других странах и на других вопросах.
Что говорят другие исследования
Which?, Британия, 2025
Крупнейшая британская ассоциация потребителей задала популярным чат-ботам, среди них ChatGPT, Copilot, Gemini и Meta AI, 40 вопросов о деньгах и правах потребителя. Copilot и ChatGPT советовали вложить в налоговый сберегательный счёт ISA больше годового лимита, за что налоговая берёт штраф. ChatGPT заявил, что страховка для поездок обязательна для большинства стран ЕС, хотя это не так. Вместо бесплатного возврата налога через налоговую боты отправляли людей в платные сервисы.
Университет Джорджии и Университет Рима Тор Вергата, 2026
Профессора финансов проверили бесплатные версии семи сервисов: ChatGPT, Claude, Copilot, DeepSeek, Gemini, Meta AI и Perplexity. Вопросы простые: сколько держать в резерве на чёрный день, как распределить вложения, сколько снимать с пенсионных накоплений в год. Общие правила боты в целом знали, но конкретные рекомендации сильно расходились от сервиса к сервису, менялись от формулировки вопроса и от того, какого пола и расы был человек в вопросе. Работа опубликована в Journal of Financial Planning.
Профессор MIT Эндрю Ло сформулировал проблему так: что бы вы ни спросили, модель всегда вернёт ответ, который звучит авторитетно, даже если он неверный.
Стэнфорд, юридические вопросы, 2024
Не финансы, но задача та же: точные правила, где ошибка стоит денег. Универсальные чат-боты ошибались в 58–82% ответов на вопросы о судебных решениях.
Самое интересное дальше. Те же исследователи проверили специализированные юридические сервисы, которые отвечают не из памяти, а по базе судебных документов. Lexis+ AI и Ask Practical Law AI ошибались больше чем в 17% случаев, Westlaw AI больше чем в 34%. Ошибок в разы меньше, но не ноль, хотя производители обещали «ответы без выдумок».
EBU и BBC, новости, 2025
Европейский вещательный союз и BBC проверили 3 000 ответов ИИ-помощников на вопросы о новостях на 14 языках. В 45% ответов была хотя бы одна серьёзная проблема, в 31% проблемы с источниками: ссылка не на то, ссылки нет или источник не подтверждает сказанное. Хуже всех Gemini: проблемы в 76% ответов.
Что общего
| Кто проверял | Что спрашивали | Главный вывод |
|---|---|---|
| Saturn, 2026 | 121 финансовый вопрос, 18 моделей | 57% ответов с ошибкой |
| Which?, 2025 | 40 вопросов о деньгах и правах потребителя | советы превысить лимит ISA и купить ненужную страховку |
| Университеты Джорджии и Рима, 2026 | сбережения, вложения, пенсия, 7 сервисов | советы расходятся между сервисами и от формулировки |
| Стэнфорд, 2024 | вопросы о судебных решениях | 58–82% из памяти, 17–34% по базе документов |
| EBU и BBC, 2025 | 3 000 ответов о новостях, 14 языков | 45% с серьёзной проблемой |
Цифры напрямую сравнивать нельзя: разные темы, страны, методики и понятие ошибки. Но картина одна. Универсальный чат-бот, который отвечает из памяти, ошибается часто и уверенно, а ошибки дорогие: штрафы, долги, неверные советы. И единственная работа из пяти, где сравнивали ответы «из памяти» и «из базы документов», стэнфордская, показывает: база снижает ошибки в разы, но не убирает их совсем.
Что из этого следует для бизнеса
Модель ошибается, когда отвечает из памяти на вопрос, где важны точные правила, цифры и предупреждения. Универсальный чат-бот ничего не знает о ваших ценах, условиях и правилах, поэтому додумывает, уверенно и красиво.
Помощник, которому можно доверить ответы клиентам или менеджерам, устроен по-другому:
- Отвечает из ваших документов и базы, а не из памяти модели. Стэнфорд показывает, что это снижает ошибки в разы.
- Показывает, откуда взял ответ, чтобы его можно было проверить. Треть проблем в исследовании EBU и BBC как раз с источниками.
- Говорит «не знаю, уточню у менеджера», вместо того чтобы придумывать правило, как с тем студенческим кредитом.
- Проверен на реальных вопросах клиентов до запуска и после каждого изменения.
Четвёртый пункт обязателен именно потому, что база ошибки не обнуляет. Методику можно взять у Saturn: соберите вопросы, которые ваши клиенты уже задают; прогоните каждый несколько раз; оценивайте не только «верно или нет», но и полноту и предупреждения; спросите одно и то же разными словами, как в работе Университета Джорджии. С этого же мы начинаем каждый проект: сначала вопросы клиентов, потом инструменты.
Вывод: 57%, 45% или 82% это цена вопроса к модели без ваших данных. С базой ошибок заметно меньше, но не ноль, поэтому доверять стоит не обещанию «ИИ не ошибается», а тесту на своих вопросах.